프로젝트: 대학원 (2024년 이후)
아래는 대학원 재학 중(2024년 이후) 수행한 프로젝트들로, 최신순으로 정렬되어 있습니다. 이전 프로젝트는 대학원 입학 전 (2024년 이전) 페이지에서 확인하실 수 있습니다. 참고로 밑에 링크로 연결된 문서들은 모두 영문으로 작성되어 있습니다.
2026
scVIP: 발달 및 질환 표현형 분석을 위한 단일 세포 전사체 데이터 기반 개인 맞춤형 모형화 방법론 개발
영문 원제: scVIP: personalized modeling of single-cell transcriptomes for developmental and disease phenotypes
2026년 4월 20일 게시(링크 & 코드베이스 링크)

이 프로젝트는 앨런(뇌과학)연구소 과학자 제인 라이 박사님(연구소 프로필, 링크드인 프로필)와 마리아노 가비토 교수님(연구소 프로필)의 지도 아래 수행되었습니다. scVIP는 수백만 개의 단일 세포 유전자 데이터를 종합해 환자 개인의 발달·노화나 질병 상태(알츠하이머병, 헌팅턴병, 류마티스 관절염 등)를 예측하는 베이지안 딥러닝 프레임워크입니다. 생성 모델(VAE, variational autoencoder)과 어텐션 기반 다중 인스턴스 학습(multi-instance learning)을 결합하여, 수많은 세포 중 어떤 세포가 질병 진행에 핵심적인 영향을 미치는지 함께 찾아냅니다.
저는 제2저자로서 모델 코드베이스 리팩토링, 재현 가능한 학습 파이프라인 구축 및 문서화를 주도했습니다. 이 논문은 2026년 4월 20일 생명과학 분야의 프리프린트 저장소인 bioRxiv에서 프리프린트로 공개되었습니다.
디지털 병리학을 위한 딥러닝: PatchCamelyon(PCam) 데이터셋 기반 종양 탐지
영문 원제: Deep Learning for Digital Pathology: Tumor Detection Using the PCam Dataset
2026년 3월 20일 작성 및 제출(링크)
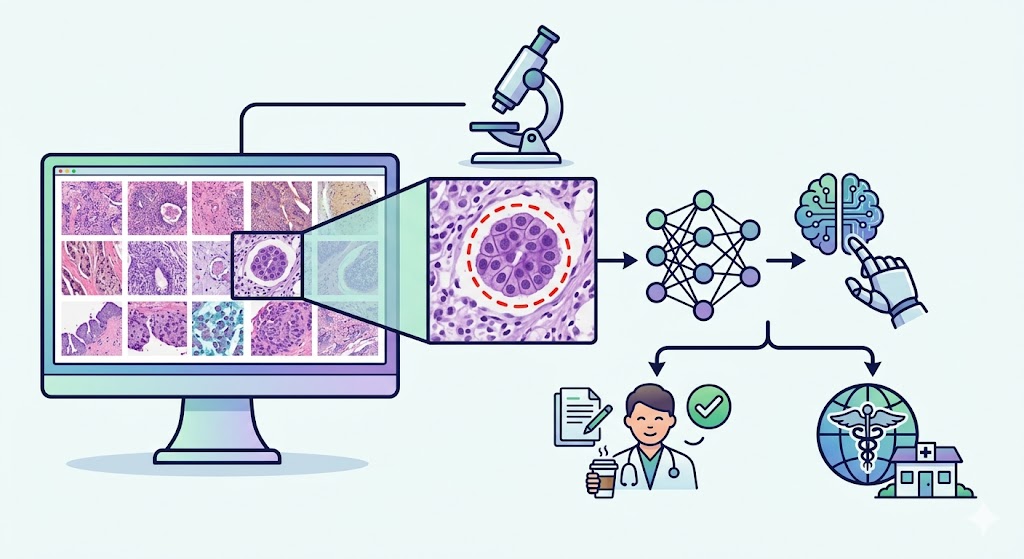
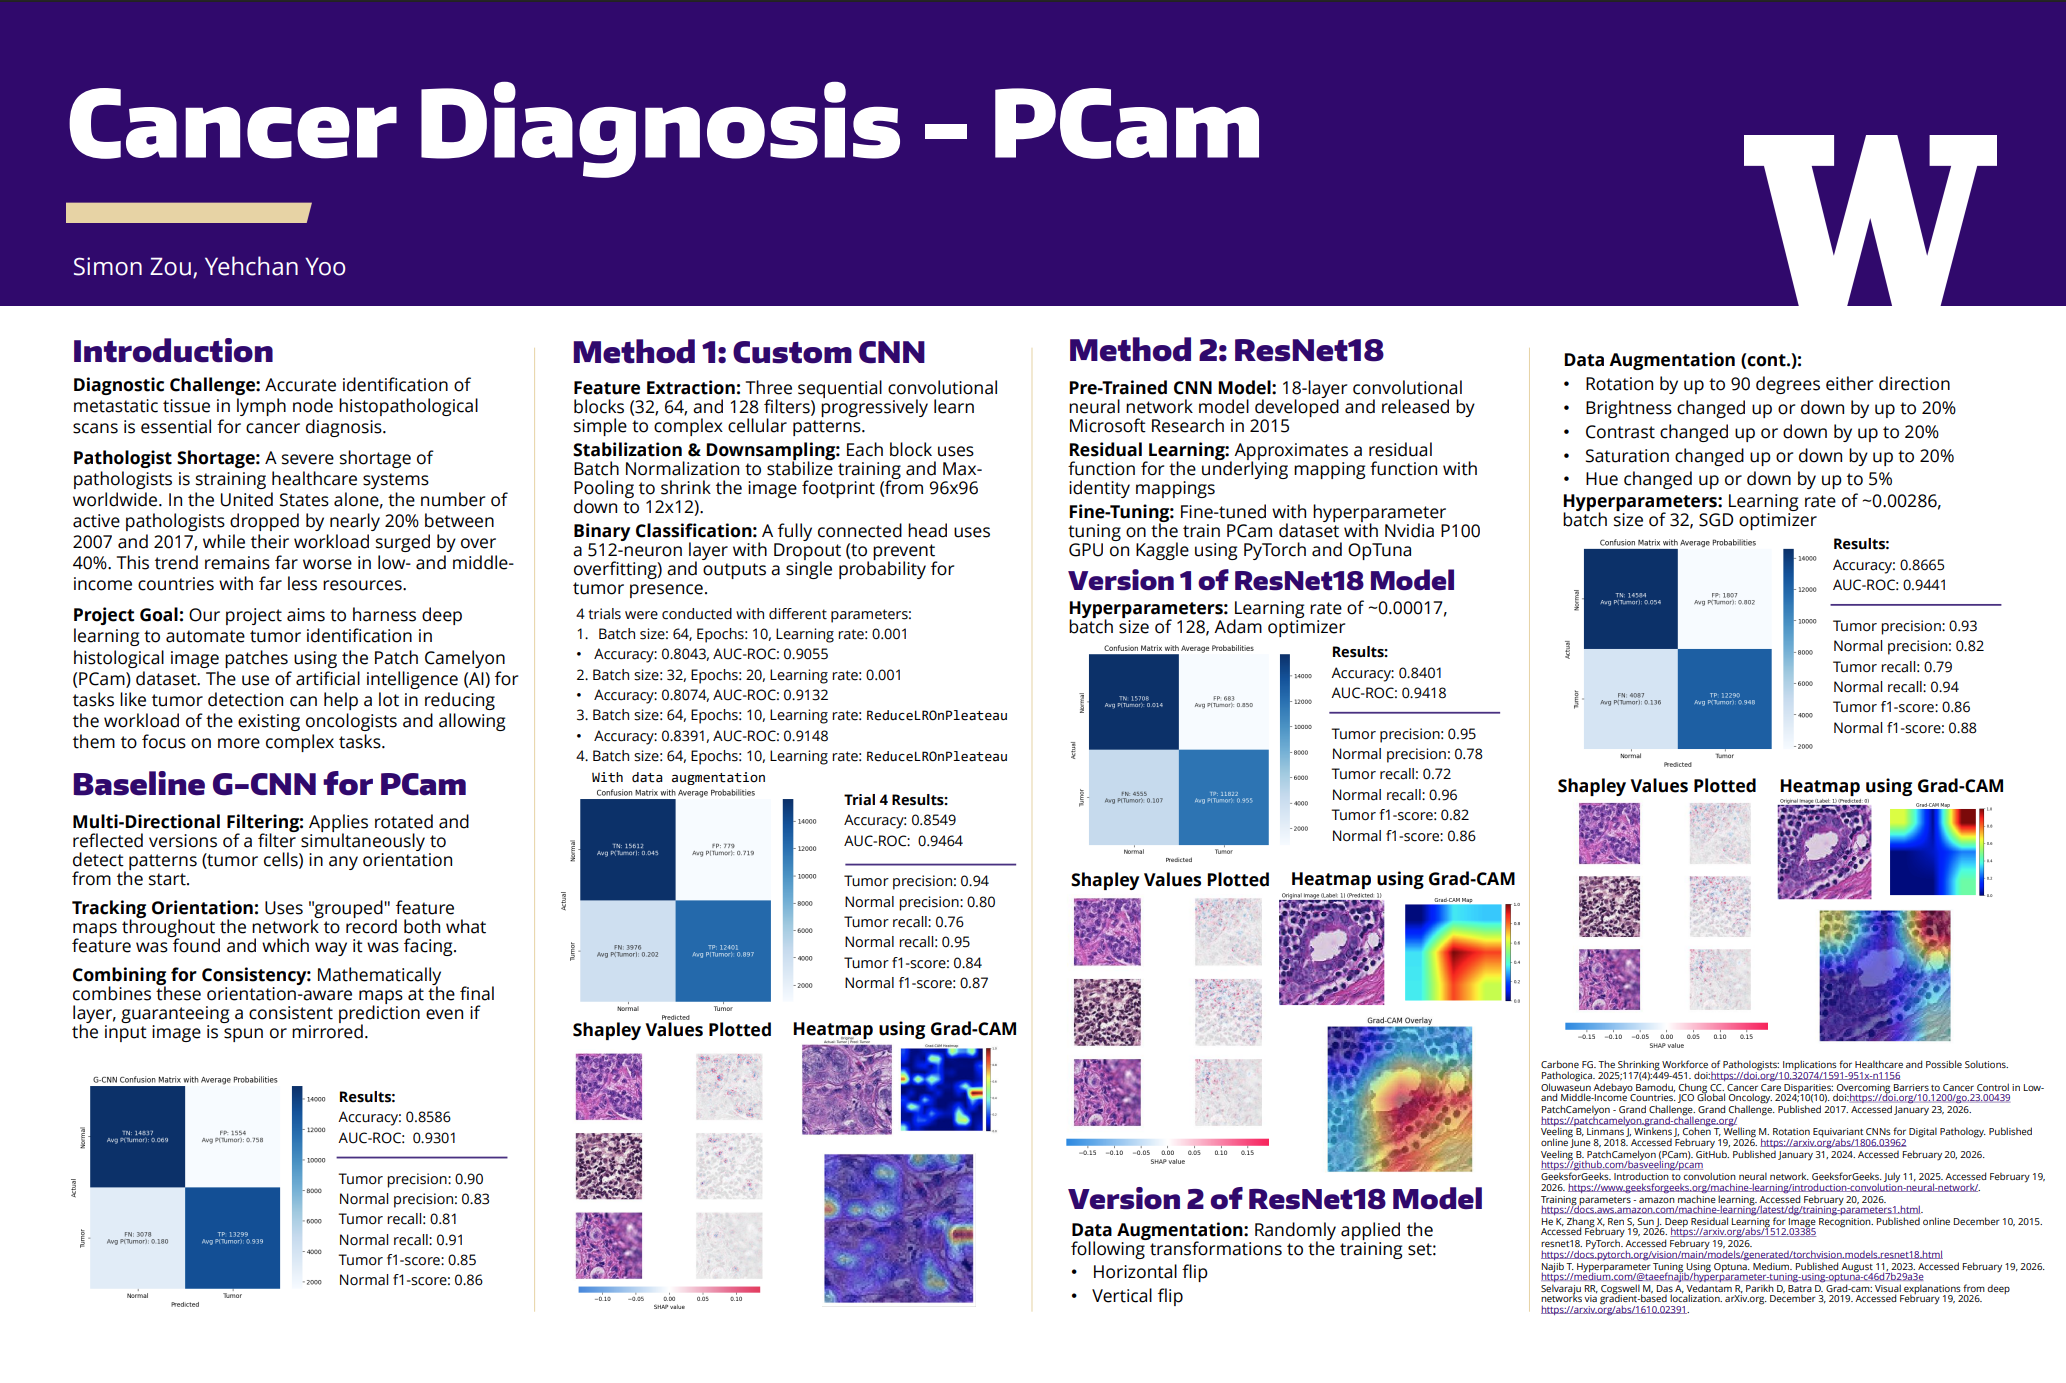
이 프로젝트는 워싱턴 대학교 전기컴퓨터공학(ECE) 대학원생 사이먼 조우(Simon Zou)와 공동으로 수행하였으며, 2026년 겨울학기 이수인 교수님의 CSE 527: 계산 생물학 - 생물학 및 생의학에서의 설명 가능한 인공지능 수업에서 진행한 기말 프로젝트였습니다. 전이성 조직의 정확한 식별은 암 진단에 필수적이지만, 의료 시스템은 병리학자 부족이라는 심각한 문제에 직면해 있습니다. 이 문제를 해결하기 위해, 본 페이퍼는 딥러닝 아키텍처를 활용한 조직병리 이미지에서의 종양 탐지 자동화에 초점을 맞추었습니다. 종양 탐지 성능을 확인하기 위해 우리가 개발한 경량화 맞춤형 합성곱 신경망 모델(CNN, convolutional neural network)을 베이스라인 등변(equivariant) 모델 및 사전 학습된 잔차 신경망(ResNet)과 비교 평가하였습니다. 모든 모델이 높은 진단 정확도를 달성했고 데이터 증강을 적용해 파인튜닝한 ResNet이 가장 높은 전체 정확도를 기록했으나, 맞춤형 합성곱 신경망 모델은 월등히 뛰어난 연산 효율성을 보여주었습니다. 또한 해석 가능성(Interpretability) 분석 결과, 사전 학습된 ResNet 모델은 넓은 공간적 특징에 집중한 반면 합성곱 신경망 모델은 세밀하고 국소적인 세포 구조에 기반해 예측을 수행했습니다. 이러한 결과는 경량화되고 해석 가능한 목적 특화 진단 도구가 더 깊은 네트워크와 대등한 경쟁력을 발휘할 수 있음을 시사하며, 환자 안전을 유지하면서도 임상 업무 부담을 줄이는 효율적인 사전 중증도 분류(Triage) 솔루션에 쓰일 수 있음을 보여줍니다.
- 이 페이퍼는 2026년 3월 12일 수업 내 포스터 세션에서도 발표되었습니다. 포스터는 아래에서 확인하거나 이 링크를 통해 접근하실 수 있습니다.
2025
사회경제적 요인 통제 하에 고객 잔고 및 신용 채무불이행이 정기예금 가입에 미치는 영향
영문 원제: The Impact of Client Balance and Credit Default on Term Deposit Subscription, Controlling for Socioeconomic Factors
2025년 12월 9일 작성 및 제출(링크)
이 페이퍼는 통계학과 석사과정 동기인 앨리슨 웡(Alison Wong)(LinkedIn, GitHub)과 공동으로 작성하였으며, 2025년 가을학기 케이티 윌슨(Katie Wilson) 교수님의 BIOST 531: 결측 데이터 분석을 위한 통계적 방법론 수업에서 수행한 기말 프로젝트였습니다. 이 연구는 포르투갈 은행의 Bank Marketing 데이터셋을 분석하여, 결측된 사회경제적 데이터를 이용하여 연평균 잔액과 신용 채무불이행이 정기 예금 가입에 미치는 영향을 분석하였습니다. 관측된 데이터 패턴을 기반으로 무작위 결측(MAR 또는 Missing at Random) 메커니즘을 가정하고, 완전사례분석(Complete Case Analysis), 베이지안 우도(Bayesian likelihood) 대치법, 다중대치법(Multiple Imputation)을 활용하여 데이터셋 내 결측 데이터를 처리하였습니다. 연구 결과, 연평균 잔액이 높을수록 정기예금 가입 확률은 약 26% 증가했으며, 신용 채무불이행은 가입 확률을 약 38~41% 감소시켰습니다. 특히, 완전사례분석은 다른 두 방법과 비교했을 때 채무불이행의 부정적 영향을 과대평가하는 경향을 보였는데, 이는 완전사례분석이 결측 데이터로 인한 잠재적 편향을 반영하지 못할 수 있음을 시사합니다.
결측 데이터 조건별 대치법 평가
영문 원제: Evaluation of Imputation Methods Under Different Missing Data Conditions
2025년 6월 9일 작성 및 제출(링크)
이 페이퍼는 워싱턴 대학교에서 로빈 메히아(Robin Mejia) 교수님의 STAT 529: 표본 조사 기법 수업의 기말 프로젝트로 작성되었습니다. 이 페이퍼는 뉴욕주 2023년 1년 American Community Survey 공공 마이크로데이터 표본에서 임대료(RNTP, rent price)와 부동산 가치(VALP, property value) 두 변수에 대해 완전 무작위 결측(MCAR, Missing Completely at Random), 무작위 결측(MAR, Missing at Random), 비무작위 결측(MNAR, Missing Not at Random) 세 가지 결측 데이터 조건에서 다양한 대입 방법의 성능을 시뮬레이션으로 평가했습니다. 각 결측 데이터 조건에 대해 무대치, 평균대치법, 무작위대치법, 최근접 이웃 대치법, 회귀대치법 등 다섯 가지 접근법을 적용하였습니다. 연구 결과, 무작위대치법은 비무작위 결측 조건에서 가장 우수한 사분위수 추정치를 제공하였으며, 평균대치법 및 회귀대치법은 평균 추정에는 더 우수하지만 사분위수 추정치를 왜곡하는 것으로 나타났습니다. 최근접 이웃 대치법은 느리고 편향이 심하여 사분위수, 평균, 중간값 추정 모두 가장 좋지 않은 결과를 보여주었습니다.
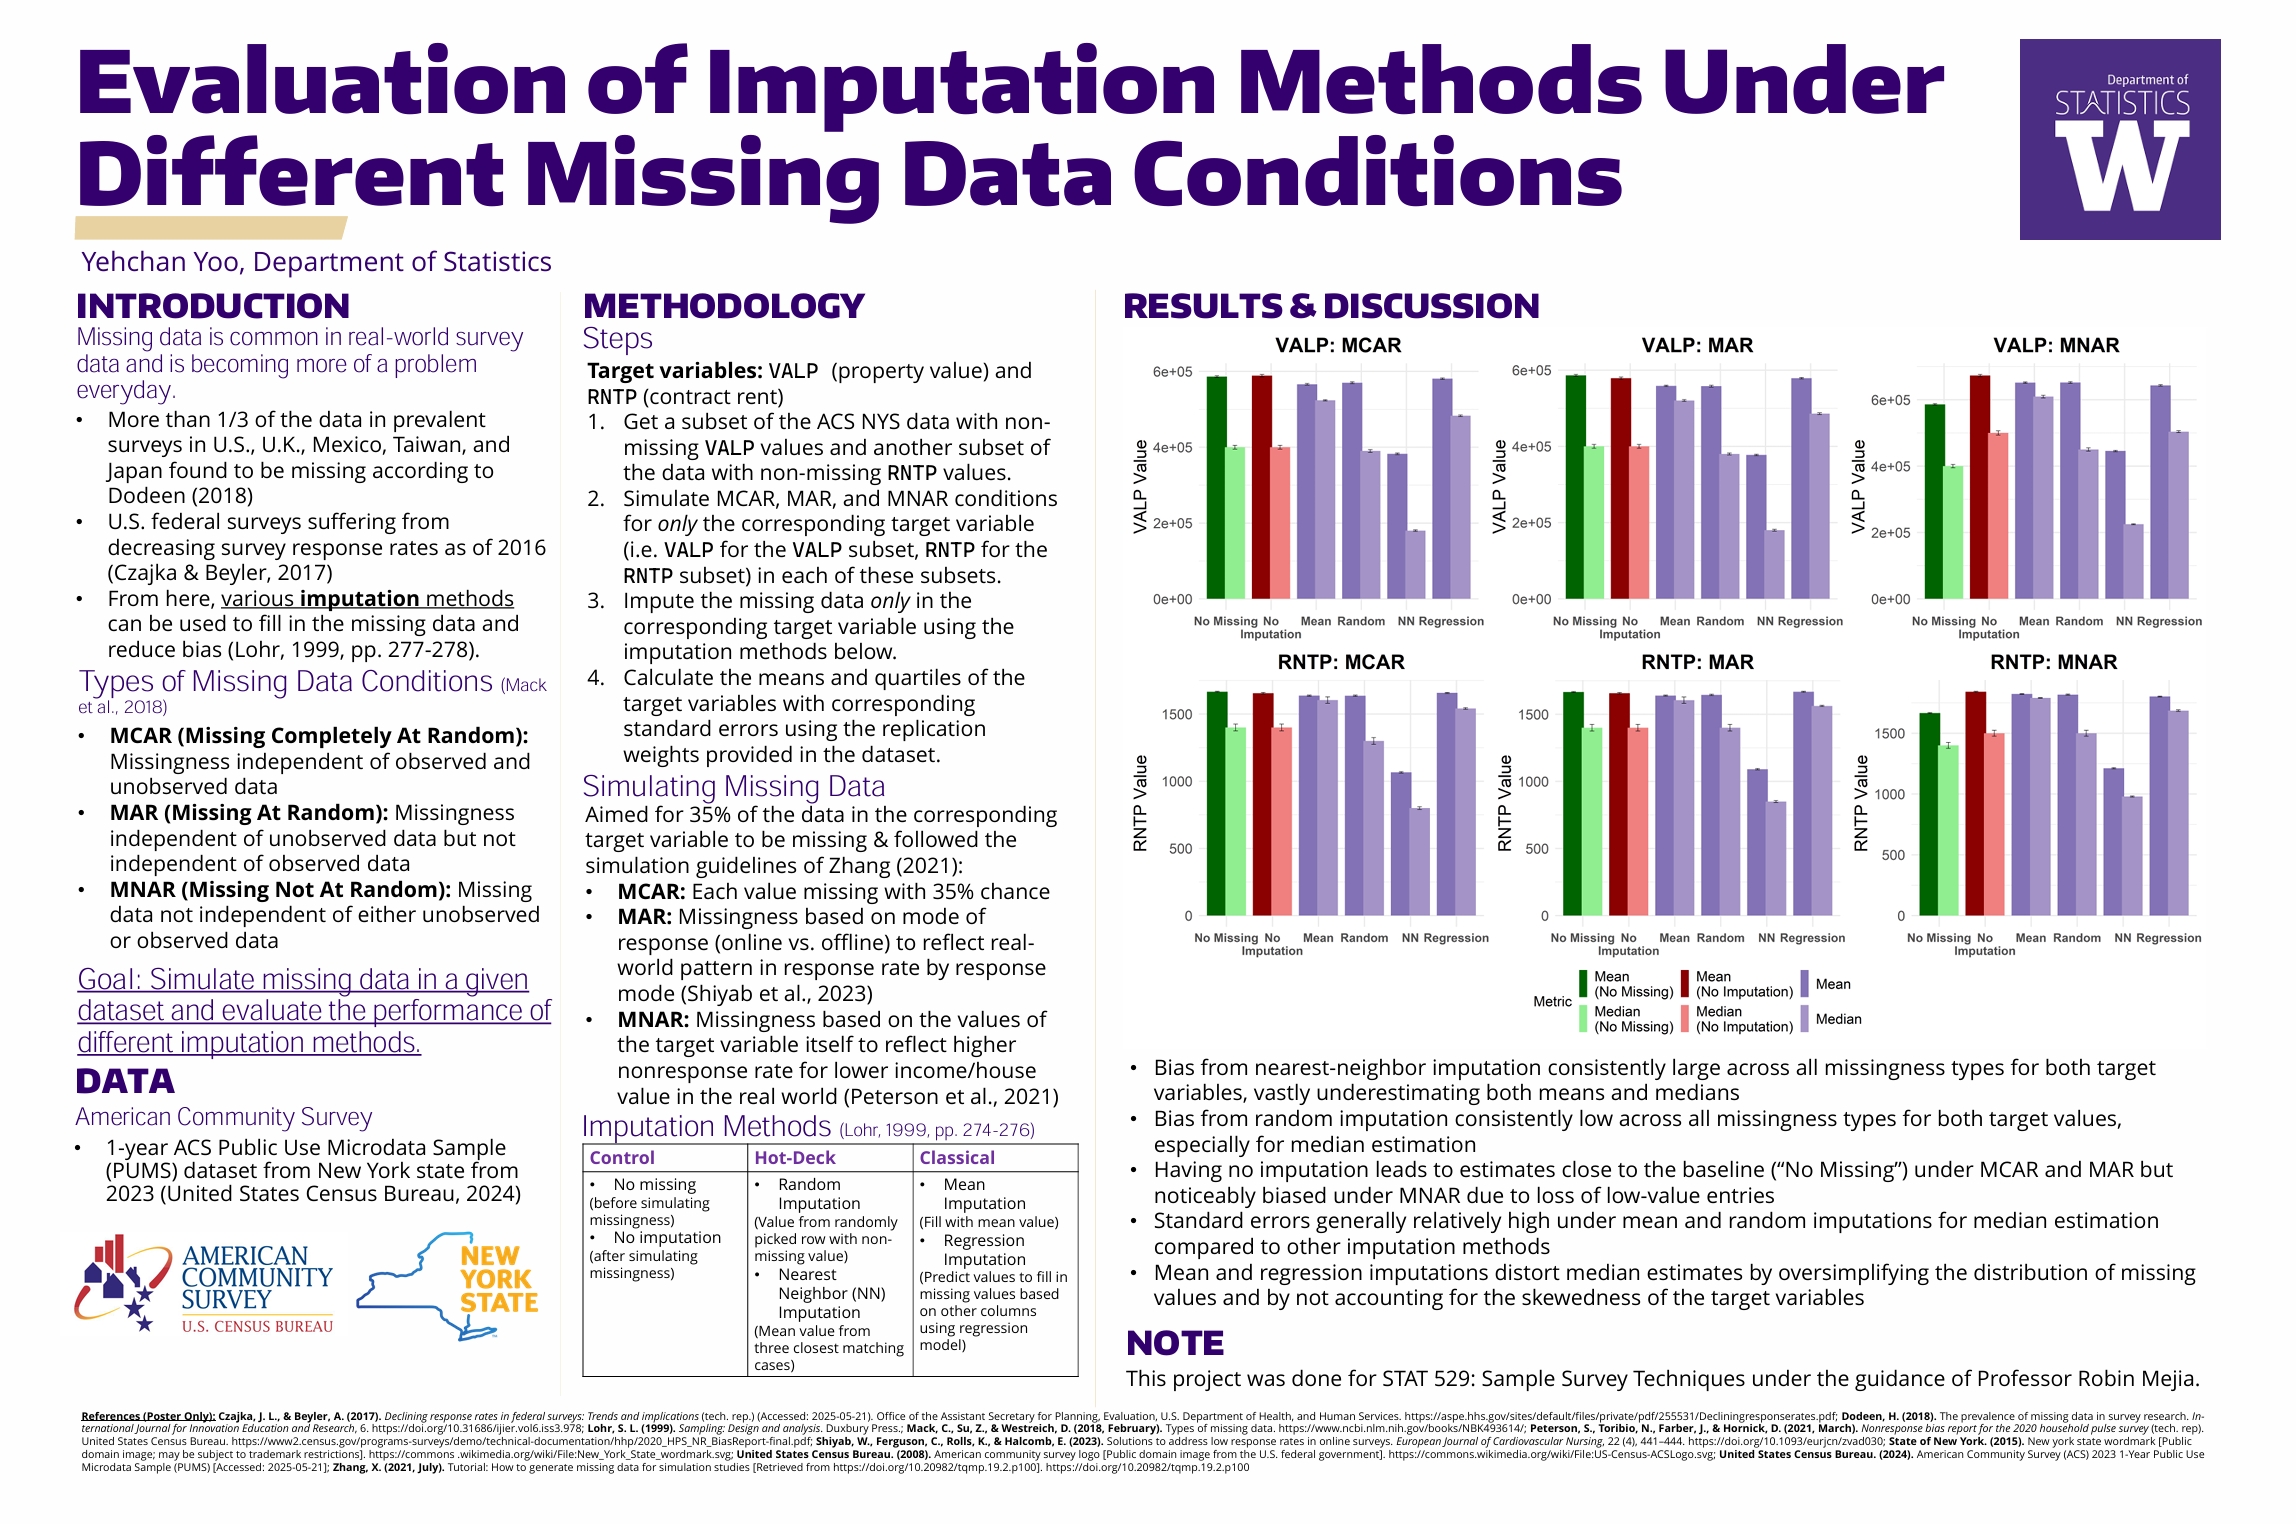
- 이 페이퍼는 2025년 6월 9일 봄 학기 워싱턴 대학교 통계·사회과학 센터(University of Washington Center for Statistics and Social Sciences) 포스터 세션에서도 발표했습니다. 이때 발표한 포스터는 아래에서 확인하거나 이 링크를 통해 확인하실 수 있습니다.
Rec-R1 재현 연구
영문 원제: Replication of Rec-R1
2025년 6월 6일 작성 및 제출(링크, Github 저장소)
 |
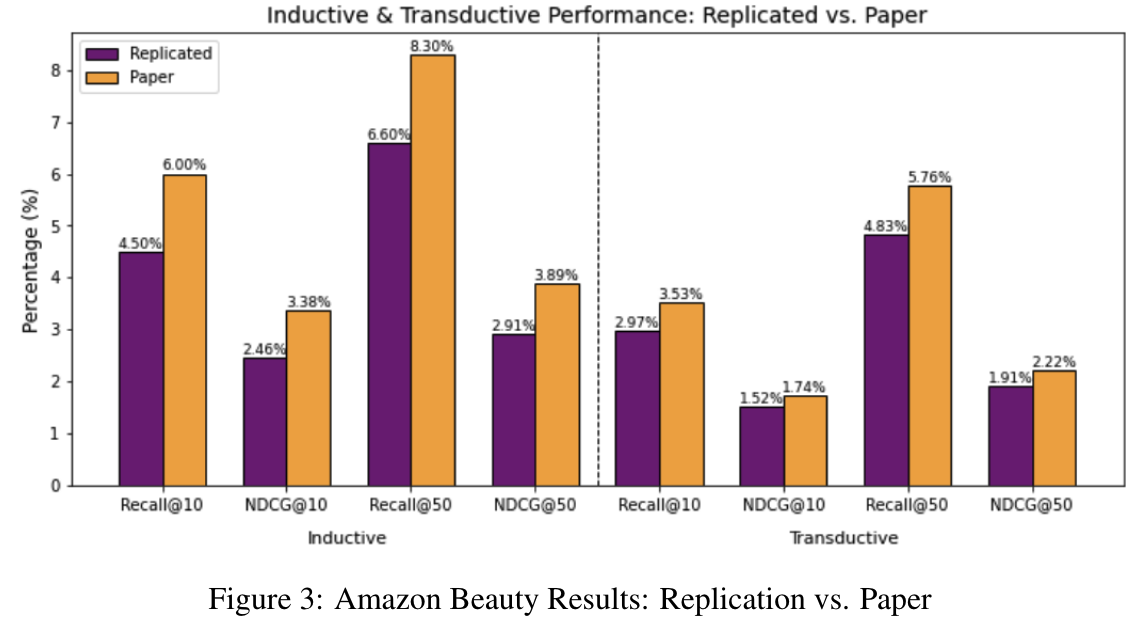 |
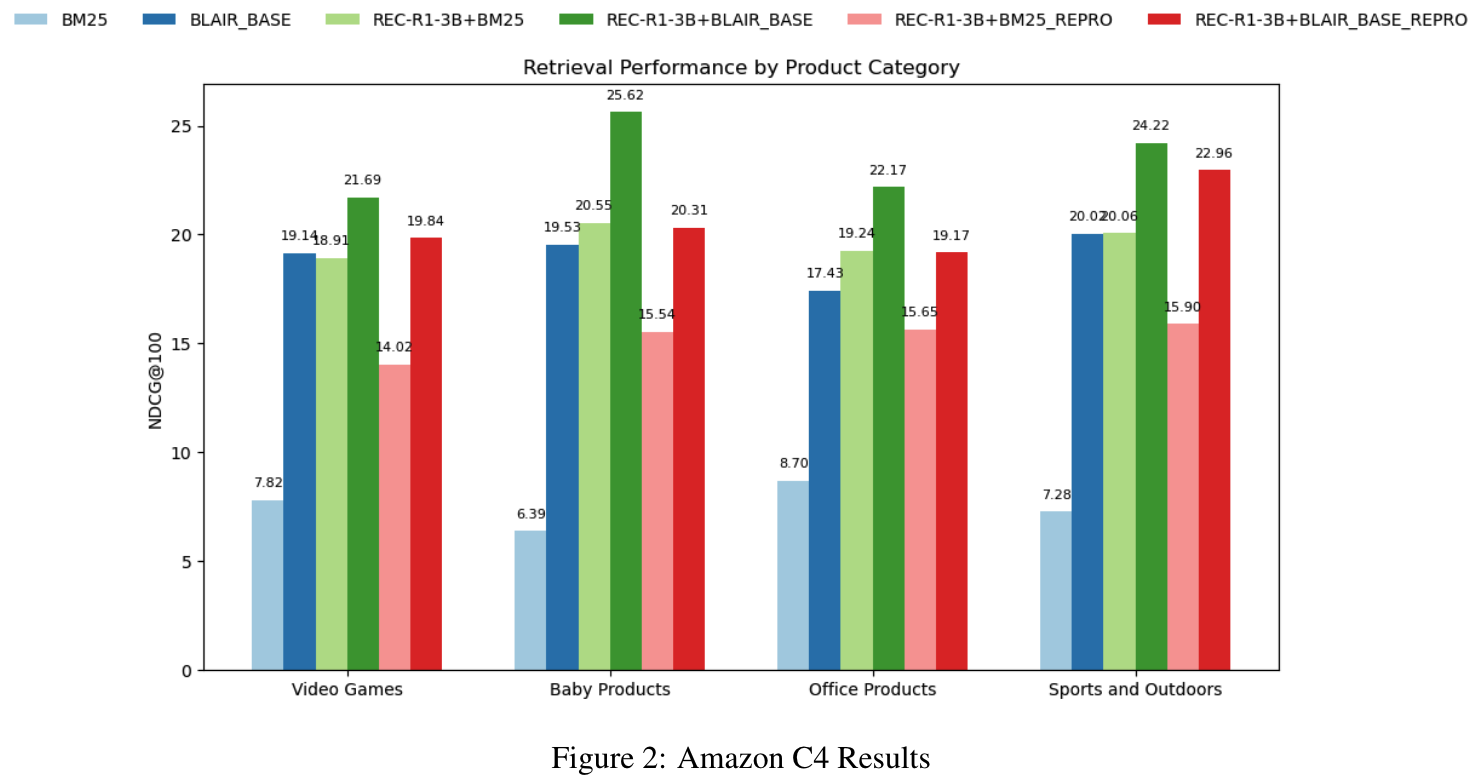
이 페이퍼는 워싱턴 대학교에서 오세웅 교수님이 가르치시는 CSE 493S/599S: 고급 머신러닝 수업의 기말 프로젝트로, 같은 수업을 수강한 채정인(Justin Chae), 요한 린드퀴스트(Johan Lindqvist), 토마스 릴리(Thomas Lilly)와 공동으로 작성하였습니다. 이 프로젝트는 대규모 언어 모델(LLM)과 추천 시스템을 결합하는 강화 학습 프레임워크를 제안한 Rec-R1 논문의 결과를 재현하는 것을 목표로 하였습니다. 공개된 코드와 데이터셋을 사용하여, 팀원들과 함께 Rec-R1이 제품 검색 및 순차적 추천 등 여러 과제에서 모델 성능을 향상시키고 지도 학습 미세 조정보다 범용 추론 능력을 더 잘 보존함을 검증하였습니다. 그러나 고용량 메모리 GPU 접근의 한계로 인해 논문의 연산 효율성 주장을 재현할 수 없었으며, 부실하게 문서화된 코드와 관련된 상당한 문제도 발견하였습니다. 이러한 어려움에도 불구하고, 이 프로젝트는 Rec-R1의 성능 이점을 확인하였으며, 재현성을 위한 더 나은 리소스 접근과 코드 유지보수의 필요성을 강조하였습니다.